受け皿となるメディア基盤の必要性
この連載の先月の記事では、NAB2026の展示から動画解析AIのMoments Lab、TwelveLabs、Digital Nirvanaの3社を取り上げ、動画解析AIが「検索」から「理解」、さらに「編集」へと進みつつあることを紹介した。これらの技術は映像から人物や物体だけでなく、感情や前後の文脈を捉えてメタデータ化し、自然文によるクエリーで目的に合ったクリップやラフカットを提示する。
しかし、AIが優れたメタデータや編集候補を生成できても、それだけでは放送局や制作会社の日常業務には使えない。解析対象となる素材をどこから取り込み、オリジナル映像素材とプロキシーをどう管理し、生成されたメタデータを誰が確認するのか。見つけた素材を編集ソフトへ渡し、レビュー、承認、アーカイブ、配信までをどう接続するのか。AIの能力を制作のワークフローへ定着させるには、その受け皿となるメディア基盤が必要である。完成資産を長期管理するMAM(Media Asset Management)や、制作中の素材や工程を扱うPAM(Production Asset Management)と呼ばれるシステムである。
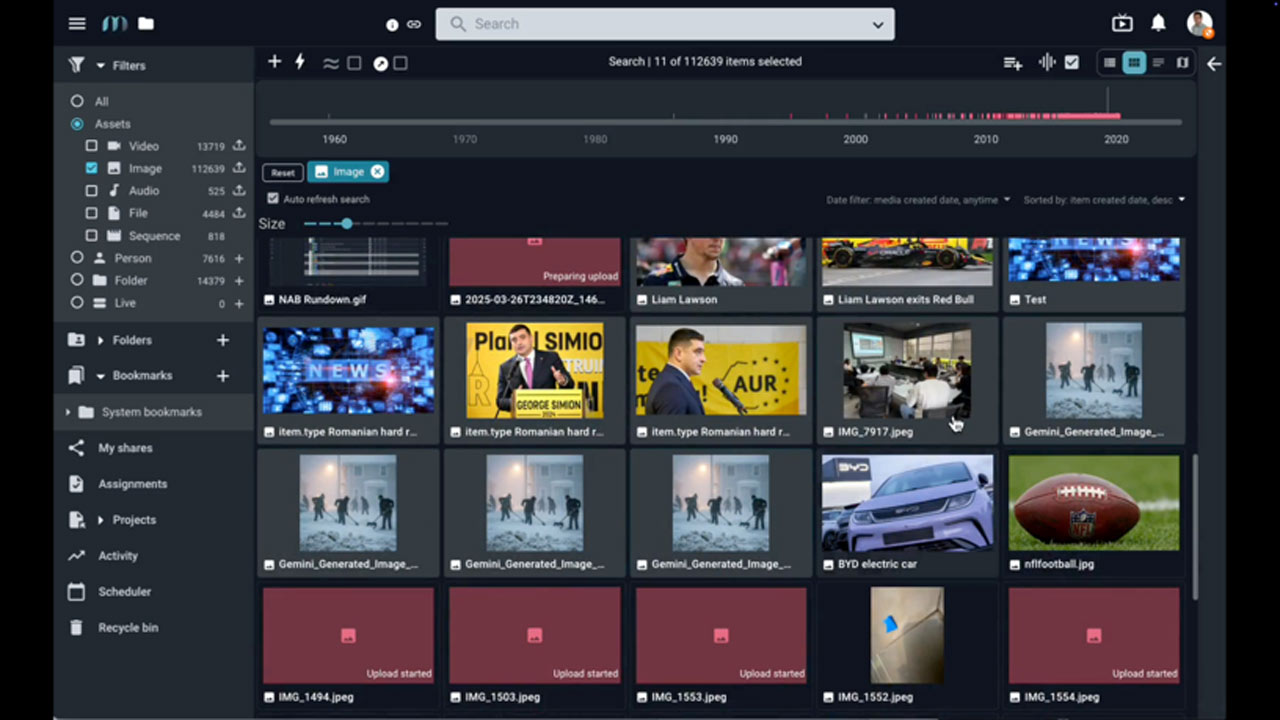
そこで本記事では、動画理解AIの上位に位置する運用レイヤーとして、NAB2026 PRONEWS TECH TOURで訪問した3つの次世代MAM/PAMメディア基盤を取り上げる。Fonn Groupの「Mimir」、Backlightの「iconik」、BRAHMA AIの「BRAHMA AI Core」である。
3製品はいずれもブラウザを中心に、AI解析、検索、共同作業、編集、配信まで行うことができるいわゆる「クラウド世代のMAM/PAM」だ。ただし、それぞれターゲットとしている用途は異なる。Mimirはニュースやスポーツの即時制作、iconikは業務コンテキストを含むメタデータ、BRAHMA AI CoreはAIによるコンテンツの発見と再利用に重点を置く。
ここでいう「クラウド世代のMAM/PAM」とは、必ずしもすべての素材をパブリッククラウドへ置く製品だけを意味しない。クラウド、オンプレミス、ハイブリッドに分散したメディアをブラウザとAPIで結び、AIサービスや編集環境を交換可能な部品(レイヤー)として組み込む。今回の3製品に共通していたのは、そのような新しいメディア基盤の姿だった。
MAM/PAM: 動画解析AIの次に必要になる「運用レイヤー」
前稿で紹介した動画解析AIは、従来のMAMが抱えていた根本的な課題を変えようとしている。従来の検索は、タイトル、収録日、人物名、番組名など、人間が事前に入力したメタデータに依存していた。そのため、メタデータが不十分であれば、素材が存在していても見つけられなかった。
動画解析AIは、映像と音声を解析し、発話、人物、物体、場所、出来事、感情、前後関係などのメタデータを自動的に生成する。これによって、編集の際に人間がすべての映像を再生して必要な箇所を見つけ出す作業が不要となり、自然文による検索で映像資産内の必要な時間位置へ簡単に到達できるようになる。また検索した素材からサブクリップやシークエンスを作り、Premiere ProやDaVinci ResolveなどのNLEへ渡すことができる。完成したコンテンツを複数の画面比率やフォーマットへ変換し、放送、OTT、SNS、FASTチャンネル、外部顧客へ届けることもできるシステムもある。
つまり、動画理解AIが映像の「意味」を作るレイヤーだとすれば、次世代のMAM/PAMは、その意味を制作チームの「行動」へ変えるレイヤーである。NAB2026で見た3製品の違いも、AIの認識精度そのものより、解析結果をどの業務へ接続するかに表れていた。
Fonn Group「Mimir」――ニュースとスポーツを検索から配信までつなぐ
Fonn Groupは、ノルウェー・ベルゲンのMedia City Bergenに本拠を置くメディアテクノロジー企業グループである。放送・制作向けのクラウド製品を開発し、傘下にMimir、ニュースルームシステムのSaga、システムインテグレーターのMediabilityなどの製品群を持つ。
Mimirは、アーカイブ管理を中心とする従来型MAMというより、制作中の素材を扱うPAMの性格を強く持つクラウド型メディア制作基盤である。一方で、保存済み素材へのAIメタデータ付与やアーカイブ検索などMAMの機能も備えており、両者の境界をまたぐ製品と言えるだろう。メディアの保管と検索にとどまらず、ニュースやスポーツに求められる迅速な制作をブラウザ上で完結させようとしている。
素材の取り込みでは、ベースバンド信号からNAS上のグローイングファイルを作成する構成、クラウドへセグメント化したTSを送る構成、オンプレミスまたはクラウドのストリームなどに対応する。URLを登録してライブソースを即時または予約収録するスケジューラーも備える。
取り込んだ映像には、文字起こし、顔認識、シーン検出、人物・物体ラベルなどの解析を実行できる。Mimir自身は「AI企業ではなくツールビルダー」という立場を取り、音声認識や翻訳などには複数の外部サービスを選択できる構成としている。特定のAIベンダーへ固定せず、言語や用途に応じてプロバイダーを差し替えられる点は、AI技術の変化を前提とするMAMにとって重要である。
デモでは、文字起こし中の単語をクリックして発話位置へ移動する検索、Donald TrumpとHillary Clintonが同時に映る場面を抽出する顔認識、人物と発話内容を組み合わせた検索などが紹介された。スポーツでは、Mohamed Salahのゴールイベントを横断して見つけ、まとめてシークエンスへ追加する例が示された。
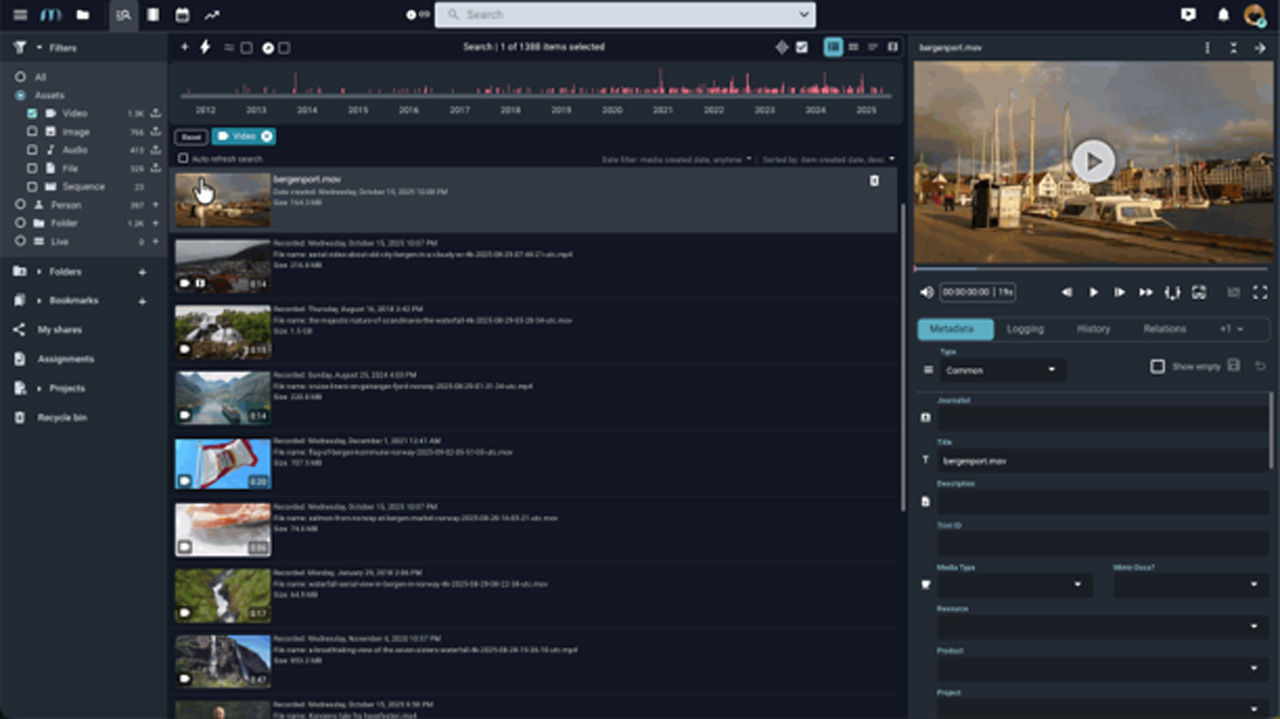
ブラウザ編集「Mimir Cutter」
Mimirの特徴は、検索結果をそのまま制作へ移せることにある。ブラウザベースの「Mimir Cutter」では、文字起こしの必要な範囲を選択してタイムラインへ追加できる。スポーツのイベントログから複数のゴールシーンを一括配置することも可能で、最大16チャンネルの音声マッピングやフレーム単位のトリミングにも対応する。
また、同じ編集内容から16:9、9:16、1:1の映像を作成し、それぞれに適したグラフィックスを適用できる。単に横長映像へ余白を加えるのではなく、縦型や正方形をネイティブな画面として扱い、グラフィックテンプレートも画面比率に応じてレイアウトを変えることができる。
説明員によれば、映像の書き出しにはセグメント並列レンダリングを採用しているので、30分の映像を約2分30秒でレンダリングでき、複数の画面比率を同時に出力できるという。処理はクラウドとオンプレミスから選ぶことができるが、原則として最高解像度の素材が存在する場所で実行する。
Adobe Premiere Pro用のパネルも提供されており、Mimir内を検索し、ライブ映像から作成したシークエンスをPremire Proの編集タイムラインへ読み込むこともできる。Mimirが目指すのは、AI検索をMAMの一機能として追加することではなく、ライブ取り込みから検索、編集、レビュー、複数フォーマット配信までを一つの時間軸で短縮することである。
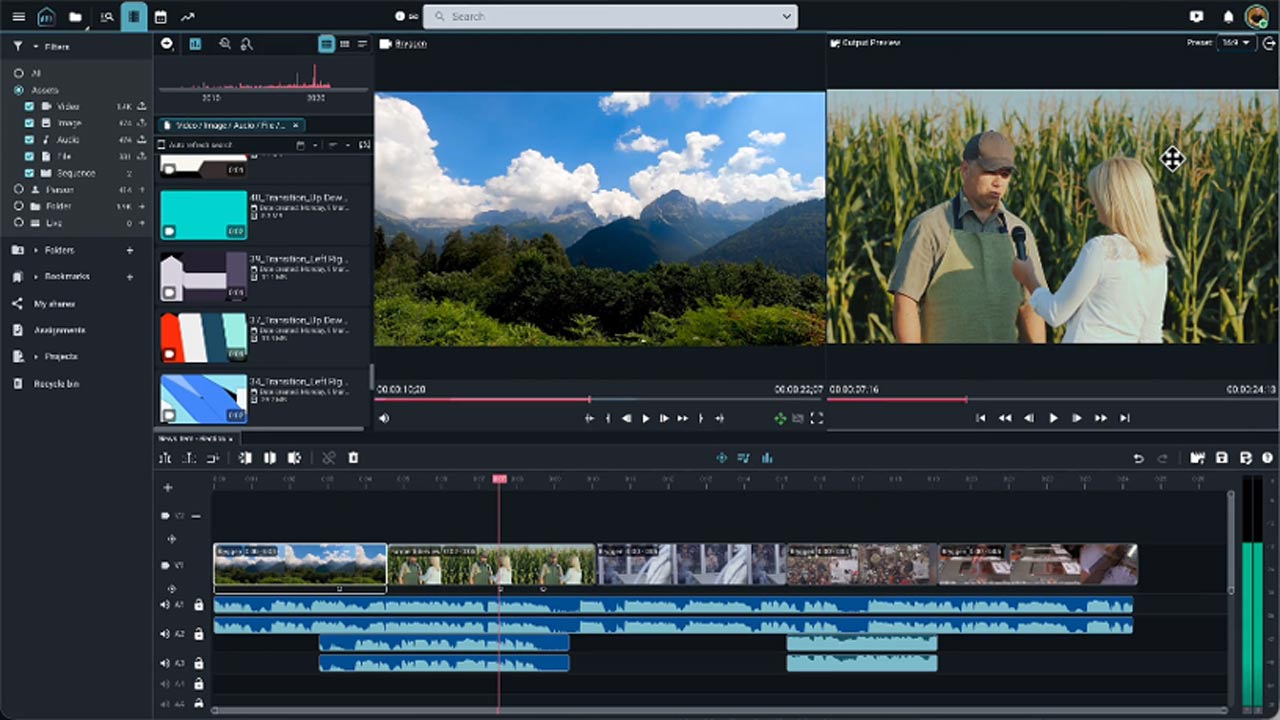
Backlight「iconik」――映像の内容だけでなく、業務コンテキストをも管理するMAM
Backlightは米国ボストンに拠点を置く、2021年設立のグローバルなメディアテクノロジー企業である。スウェーデンにルーツを持つクラウドMAMのiconikをはじめ、フランスにルーツを持つライブ映像制作のWildmokaの二つの製品を中心に、制作管理のftrack(スウェーデン)、脚本制作のCeltx(カナダ)、OTT基盤のZype(米国)などの製品群を買収によって集め、映像制作から配信までを一つの企業グループでカバーする体制を整えている。
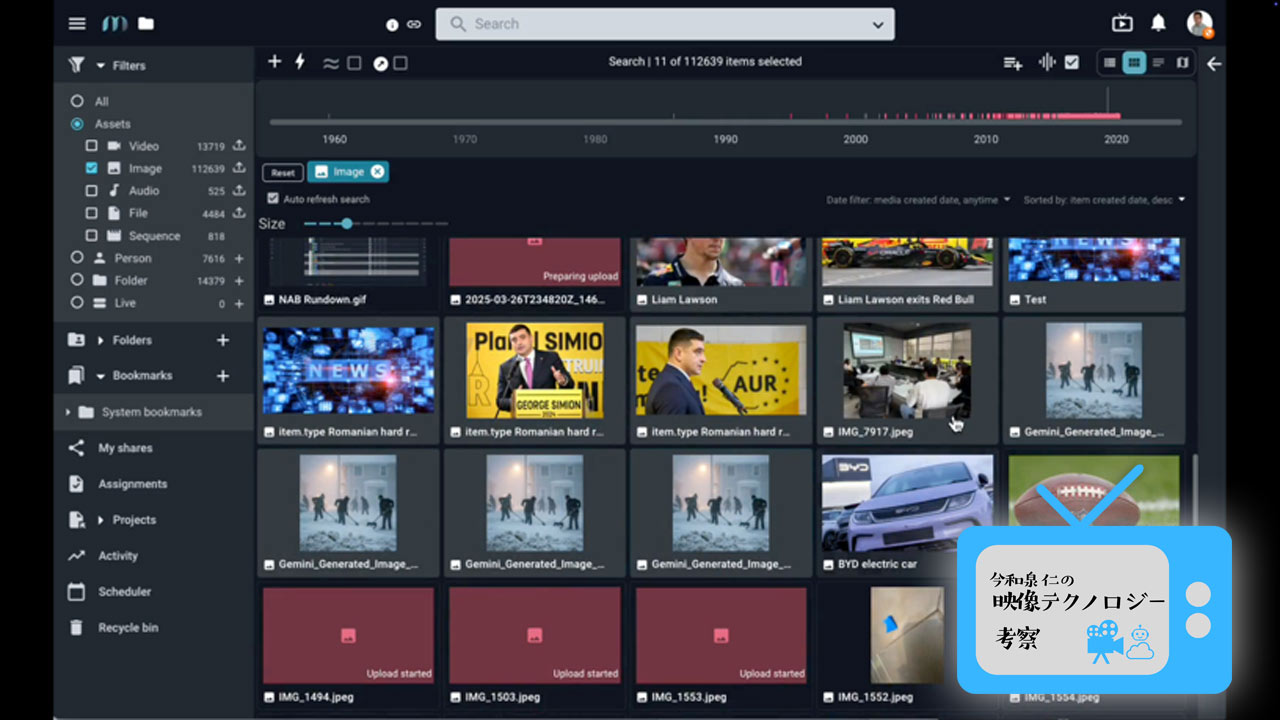
主力製品のiconikは、クラウドとオンプレミスに分散したストレージを横断し、ブラウザ上で素材の検索、レビュー、承認、共有を行うクラウドネイティブのMAMである。AIによる顔認識、物体認識、文字起こし、自動タグ付けなどを備えるが、デモで繰り返し強調されたのは、映像フレーム内の情報だけでは実務に十分なメタデータにならないという考え方だった。
iconikは、ファイルパス、保存場所、ユーザーが行った選択、番組、部署、プロデューサーといった業務コンテキスト上の情報を、映像解析で得たメタデータと結び付ける。例えば同じ人物が映っていても、それがどの番組の、どの部署が管理する、どの制作段階の素材なのかによって利用目的は異なる。iconikは、映像の意味と組織の文脈を同じ検索基盤で扱おうとしている。
顔認識では、検出した二つの顔が同一人物かを利用者が確認し、モデルを補強できる。文字起こしにはGoogle、AWS、Rev AIなどを利用でき、外部サービスによる翻訳にも対応する。展示では、生成AIがコンテンツを分析してメタデータフィールドを入力する「GenAI Suggested Metadata」も紹介された。バスケットボール映像から、スポーツ用に定義した複数のフィールドをまとめて生成するデモである。
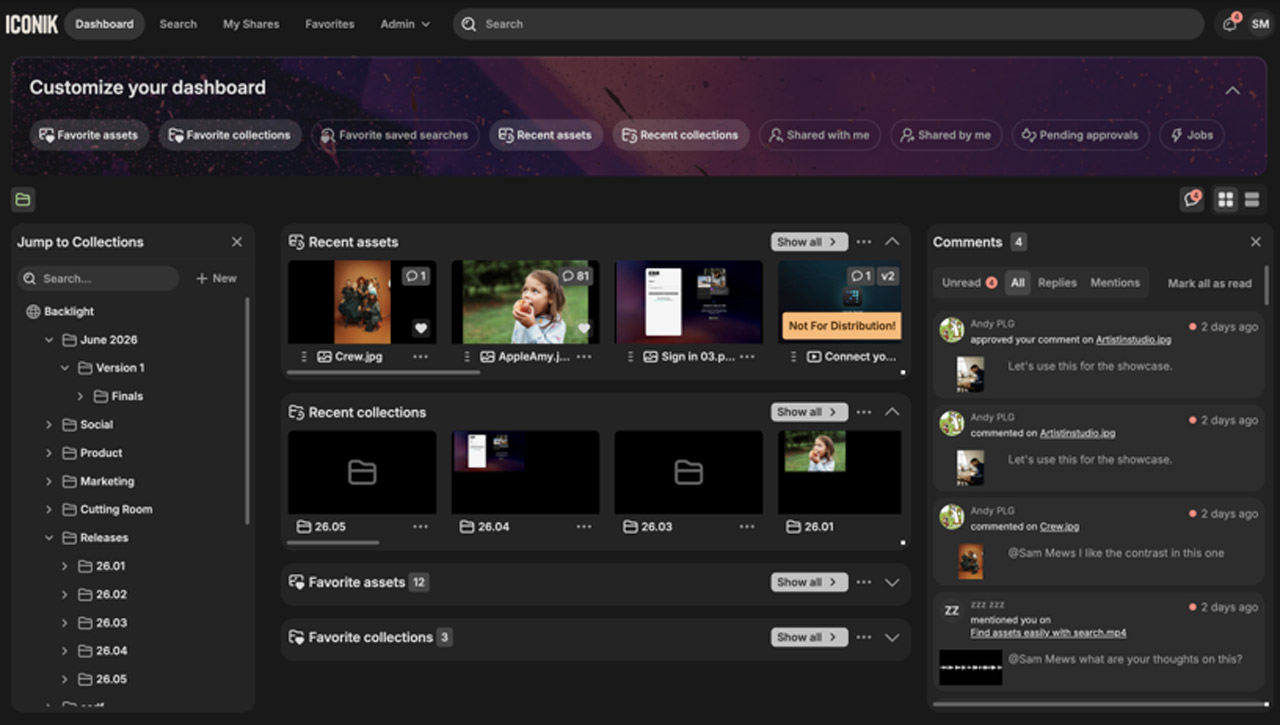
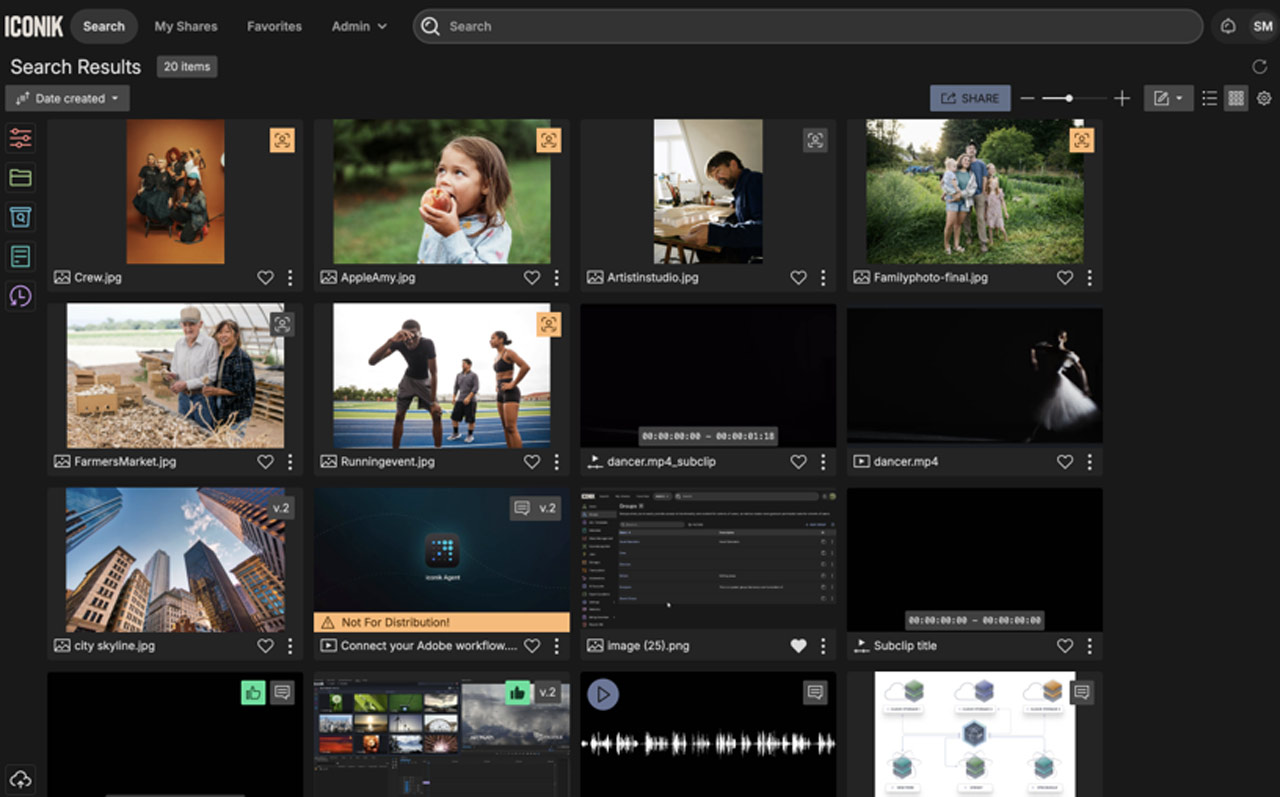
Wildmokaとの連携によるメディア検索・編集・公開の一気通貫ワークフロー
前回の記事では、Moments LabやTwelveLabsが動画そのものをベクトル化し、意味や文脈を検索する方向を紹介した。これに対しiconikは、ベクター埋め込み型の映像検索について、ライブラリー全体へ適用した場合のコストとスケーラビリティー、ベクターデータがフレーム内の情報しか考慮しないために業務コンテキストを捉えにくい点などを課題として挙げた。
しかしiconikがサードパーティの動画解析AIの利用を制限しているということではない。実際、iconikはAPIとデータモデルを公開し、TwelveLabsやMoments Labを含む外部AIとの連携を可能にしている。顧客がライブラリーの一部へ高度な映像解析を適用し、結果をiconikのメタデータと組み合わせる構成も想定されている。
Adobe Premiere ProやDavinci ResolveなどのNLEでは、iconikが提供するプラグインによって、検索や素材選択を編集ソフト内から行える。編集端末からアクセス可能なローカルストレージに高解像度素材が存在する場合、クラウドから再ダウンロードせず、そのファイルを直接Premiere Proへ読み込むことができる。クラウドMAMでありながら、素材の実体を必ずクラウドへ移動させる必要がない点も、ハイブリッド運用を前提とした設計である。
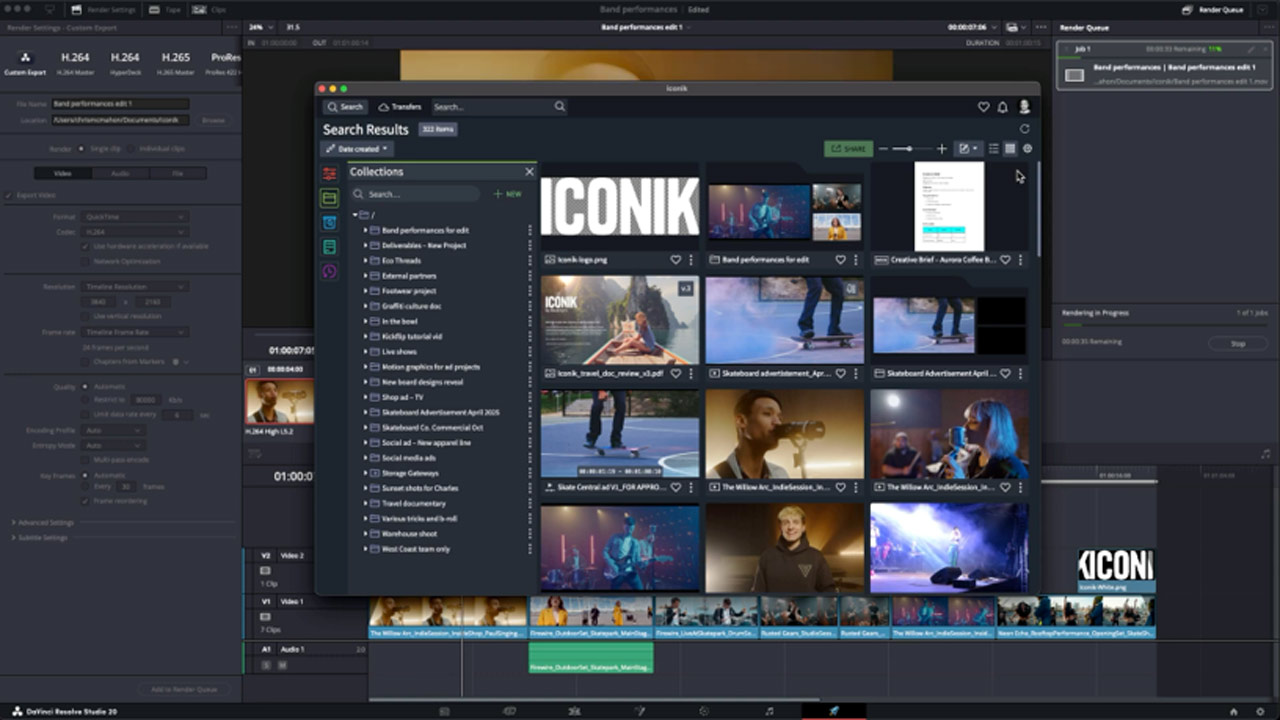
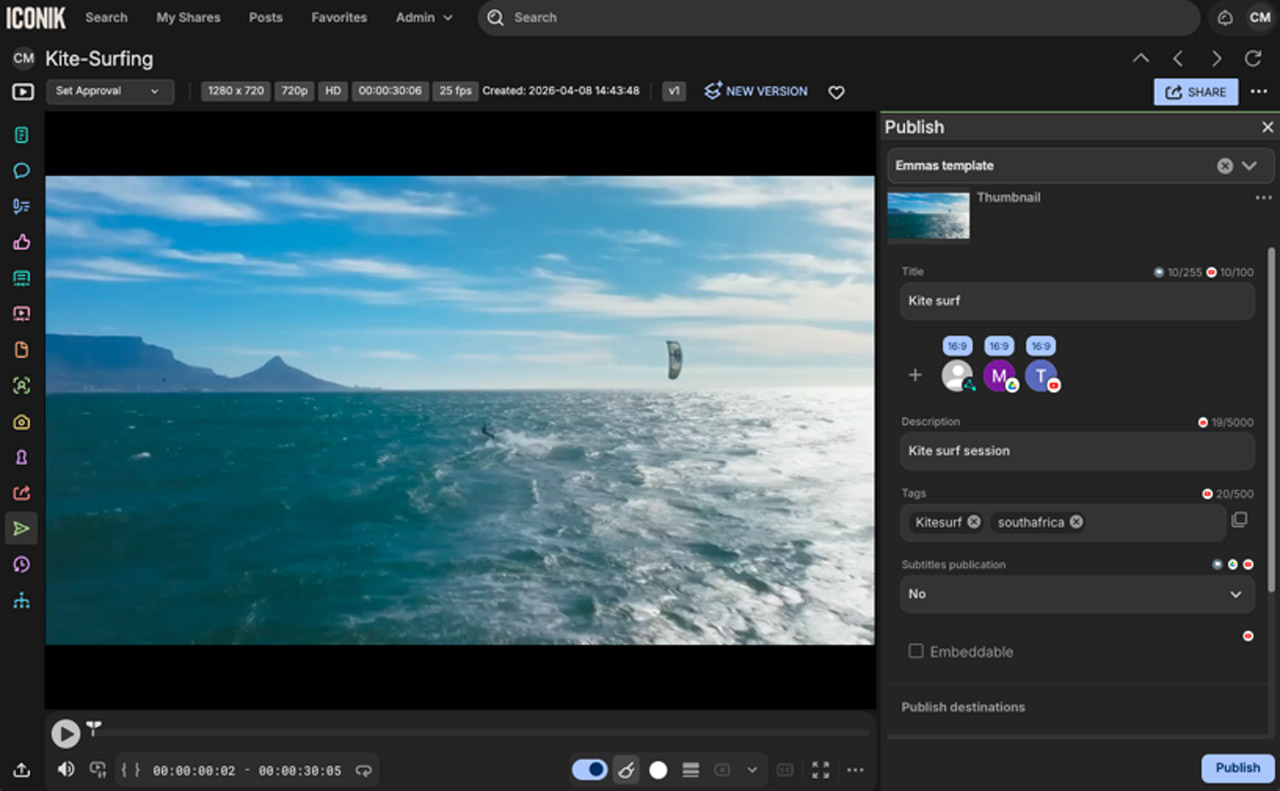
IBC2026では、同社の二つの主力製品、iconikとWildmokaを連携させたソリューションも発表される模様だ。ライブ/ニアライブのクリッピング、SNS配信を行うWildmokaとiconikを統合することで、iconikの高度なメディアインテリジェンス機能を活用してコンテンツをより迅速に見つけ出し、Wildmokaによってライブからデジタルへの配信を効率化し、SNS等へのパブリッシュまでを一気通貫で提供する。このためWildmokaのパブリッシング機能を「iconik Publish Panel」としてiconikに直接統合するということが発表されている。
「BRAHMA AI Core」―AIで発見した素材を再利用可能な資産へ変える
BRAHMA AIは、英国ロンドンに本社を置き、インド・ムンバイ発のPrime Focusグループを母体とする企業向けAIコンテンツプラットフォームである。Prime Focus Technologies(PFT)の技術基盤を継承して2024年に発足し、2025年初頭に生成AI企業Metaphysicと統合した。
BRAHMA AIの製品は、メディアを管理・解析する「BRAHMA AI Core」と、生成AIによるクリエイティブ機能を提供する「BRAHMA AI Studio」に大別される。Coreは、PFTが17年以上にわたり展開してきたMAM「CLEAR」とマルチモーダルAI基盤「CLEAR AI」を継承・発展させたものだ。一方、StudioにはMetaphysicのデジタルヒューマン「ATMAN」や音声ローカライズ「VAANI」などの技術が組み込まれている。今回のデモではCoreを中心に、AIによって映像ライブラリーを検索可能かつ再利用可能な状態へ変える機能が紹介された。
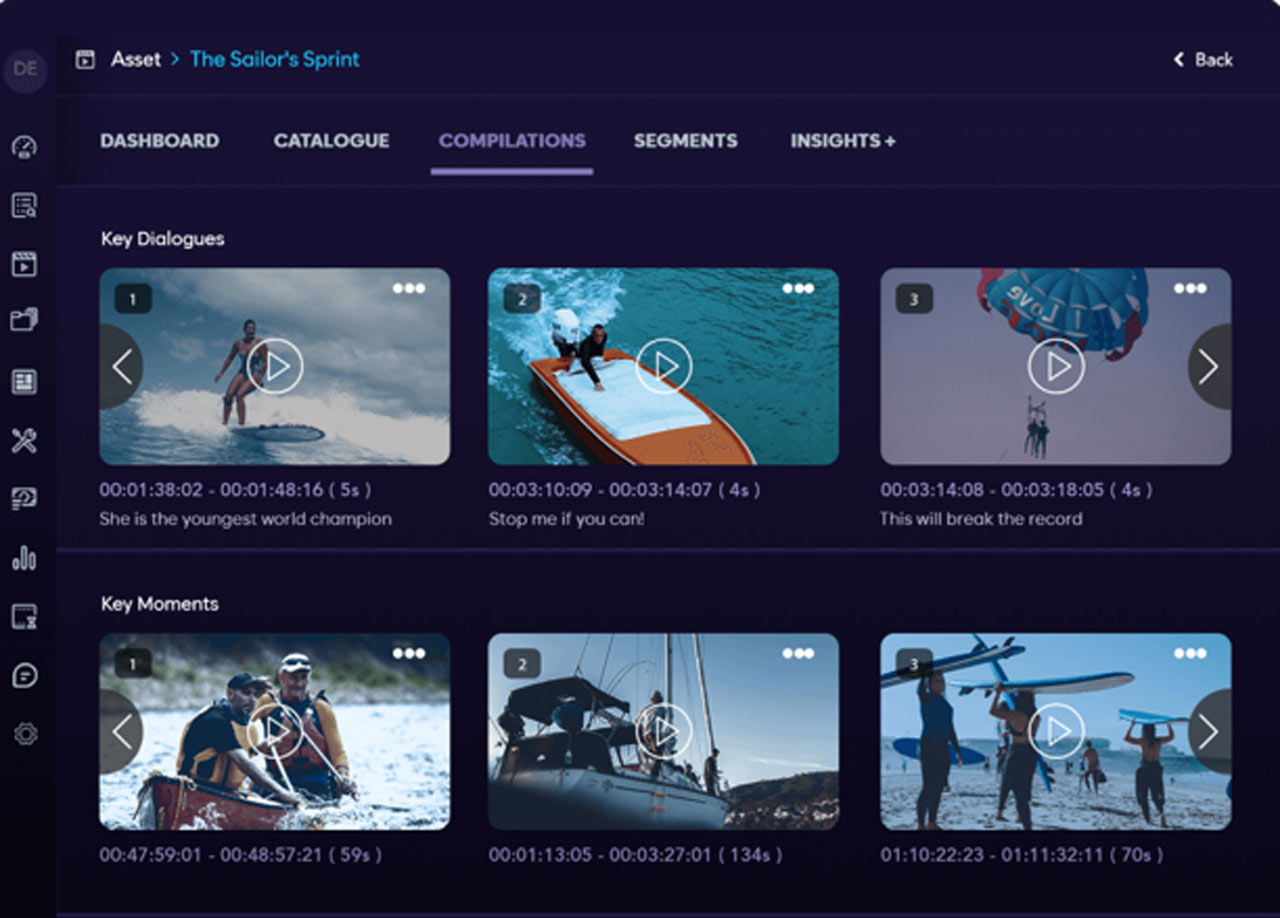
Coreは、長尺コンテンツをシーン、クリップ、フレームの階層に分解し、音声、人物、話者、物体、ブランドロゴ、画面内文字、広告ブレークなどを検出する。映像をファイル単位で管理するだけでなく、番組内の各場面について詳細なメタデータを作り、自然文からアクセスできる情報基盤に変える。
デモでは、「特定の俳優が登場する重い場面」のような曖昧な表現を入力し、単純なキーワード一致ではなく、感情や場面の意味を含めて検索する例が示された。日本語での検索にも対応するという。検索結果から複数のアクションシーンをプロジェクトへ追加し、クリップ集を構成する操作も紹介された。

スポーツ向けには、サッカーのゴール、フリーキック、イエローカード、負傷場面、野球のストライクやホームランなどを検出し、ハイライトを生成する。AIが検出したイベントから利用者が選択する方法と、あらかじめ設定した条件に基づいて自動構成する方法の双方が用意されている。
さらに、検索した横長映像を縦型へ変換し、被写体を追跡しながらSNS向けの画角に調整する。ロゴを追加して派生コンテンツを作るところまで、同じ環境で処理できる。
前回記事で紹介したTwelveLabsのRodeoやDigital NirvanaのRoughCut、MimirのMimir Cutterなどと同様、BRAHMA AI Coreも検索結果を返して終わらず、「見つけた素材に何をさせるか」へ踏み込んでいる。ただし、BRAHMA AIの射程はMAM内のラフカットにとどまらない。Coreで蓄積した構造化データをStudio側の生成、ローカライズ、派生コンテンツ制作へ渡し、コンテンツサプライチェーン全体で利用する構想である。
動画理解AIによって得たメタデータを、一度の検索結果ではなく、今後の制作と収益化に利用できる組織資産として保持する。そこがBRAHMA AI Coreの中心的な価値といえる。
3製品は動画理解AIをどこへ接続するのか
3製品を並べると、次世代のMAM/PAMを含むメディア基盤の競争が、単なる「AI搭載機能の数」ではないことが分かる。文字起こし、顔認識、物体認識、セマンティック検索といった機能は、多くの製品で共通になりつつある。違いは、AIが生成した情報をどの工程へ運ぶかにある。
Mimirは、ライブ素材の取り込みから検索、ブラウザ編集、マルチフォーマット出力までを短時間でつなぐ。ニュースやスポーツなど、素材の価値が時間とともに下がる領域に適した設計である。
iconikは、動画内の情報と、ファイルパス、部署、番組、ユーザー操作などの業務コンテキストを結び付ける。高度な動画理解AIを外部サービスとして利用しながら、組織全体のメタデータと共同作業を管理する基盤となる。
BRAHMA AI Coreは、映像をシーンやフレームまで解析し、自然文検索、ハイライト生成、縦型化、派生コンテンツ制作へつなぐ。AIによるコンテンツ再利用をMAMの中心に置くアプローチである。

「最も賢いAI」ではなく「どこまで業務をつなげるか」
前回記事で紹介したMoments Lab、TwelveLabs、Digital Nirvanaは、映像からどこまで深い意味を抽出できるかを競っていた。今回のMimir, iconik, BRHAMA AI Coreの3製品は、その意味を実際の制作や事業へどう定着させるかを提供しようとしている。
両グループは競合する場合もあるが、本来は異なるレイヤーとして組み合わせることができる。動画基盤モデルが映像を解析し、MAMがその結果を保存する。人間が修正した人物名や番組固有の情報をMAMからAIへ戻し、検索精度をさらに高める。検索結果をブラウザ編集やNLEへ送り、完成した映像を再びMAMへ登録する。さらに、権限と権利情報に基づいて配信先や顧客へ届ける。
この循環が成立すると、MAMは保管場所を示すデータベースから、組織の映像資産を理解し、動かすための、いわば「映像資産活用のオペレーティングシステム」となる。
動画解析AIは、編集者が映像を見る負担を減らし、これまで見つからなかった素材へ到達する手段を提供する。しかし、その価値を継続的なコンテンツ制作へ変えるのは、素材、メタデータ、人、編集、配信を結ぶMAMやPAMである。
AIが映像を「検索し、理解し、編集する」段階から、その知能を組織全体で「管理し、運用し、流通させる」段階へ。NAB2026で見た3つのMAMは、動画解析AIレイヤーやNLEなどと連携することで新たなワークフローの形を示していた。
WRITER PROFILE