Appleは、新しいMac miniに搭載されるM6と、新しいMac Studioに搭載されるM5 Ultraを発表した。M6はApple初の2ナノメートルプロセスを採用したチップで、M5 UltraはMシリーズのシステムオンチップ(SoC)として初のクアッドダイ構成を採用する。
M6は、CPU、GPU、Neural Engineなどの各演算ブロックを強化し、処理性能を向上させている。12コアCPUと、各コアにNeural Acceleratorを備えた12コアGPU、16コアNeural Engineを2基備える構成、最大170GB/sのユニファイドメモリ帯域幅を備える。CPUについてAppleは、世界最速のCPUコアを備えるとしている。
M5 Ultraは、次世代のUltraFusionテクノロジーを使用し、MシリーズのSoCとして初めてクアッドダイアーキテクチャを採用。最大36コアCPUと最大80コアGPUを搭載し、M3 Ultraと比較して50%高速な最大1.2TB/sのユニファイドメモリ帯域幅を備えている。
Appleのシリコンエンジニアリンググループ担当バイスプレジデントであるスリ・サンタナム氏は、次のようにコメントしている。
サンタナム氏:Appleは本日、驚くほど先進的なM6と、これまでで最もパワフルなMシリーズチップであるM5 Ultraを発表し、AppleシリコンのパフォーマンスとAI演算を飛躍的に進化させます。
最先端の2ナノメートルプロセスを使って作られたM6は、新しいCPUコンプレックスと、これまでより2つ多いCPUコアとGPUコア、デュアル16コアNeural Engine、さらに大きくなったユニファイドメモリ帯域幅を組み合わせ、驚異的なエネルギー効率でワークロードを処理します。
また、究極のデスクトップパフォーマンスと大規模なAIモデルを実行するために、M5 Ultraは、Neural Acceleratorを備えた膨大なGPUと、より大きなユニファイドメモリ帯域幅を備え、デスクトップでできることの限界を押し広げます。
M6:最適化された設計と強化されたパフォーマンス
M6は、一般ユーザーや学生、デベロッパ、AI関連の用途、企業でのワークフローなどを想定し、パフォーマンス、電力効率、オンデバイスAI処理を強化した。
最先端の2ナノメートルプロセステクノロジーを採用し、より小さなダイに高密度でトランジスタを搭載することで、パフォーマンスと電力効率を向上させている。また、16コアNeural Engineを2基備え、前世代と比較して最大2倍高いピーク演算性能を発揮する。システムフレームワークが両方のエンジンを同時に活用することで、AIモデルの実行を高速化する。
M6は、M5より2コア多い12コアCPUを備え、2つのスーパーコア、4つの高性能コア、6つの高効率コアで構成されている。Appleによると、世界最速のシングルスレッド性能を実現し、マルチスレッド性能はM5と比較して最大1.2倍、M1と比較して最大2.4倍高速だという。
スーパーコアはシングルスレッド処理を担い、高性能コアはスーパーコアと連携して高負荷なマルチスレッド処理を実行する。高効率コアはバックグラウンドタスクなどを担当する。画像編集、コードのコンパイル、ファイルのインデックス作成、エージェント型AIワークロードなど、高負荷なCPU処理の高速化を図っている。
高速化されたGPUとメモリ帯域幅
M6は、M5より2コア多い12コアGPUを搭載し、各コアにNeural Acceleratorを備える。AI処理におけるGPUのピーク演算性能は、M5と比較して約30%、M1と比較して8倍以上向上したという。これにより、オンデバイスLLMを利用する際のプロンプト処理などを高速化する。
さらに、シェーダコアアーキテクチャのアップデート、Dynamic Caching、ハードウェアアクセラレーテッドレイトレーシングなどのグラフィックス機能を搭載。レンダリング性能やフレームレートの向上を図っている。また、複雑なグラフィックス処理におけるジオメトリレートは50%向上した。
M6は最大32GBのユニファイドメモリに対応し、複数の高負荷アプリを同時に使用するマルチタスクや、LLMをオンデバイスで実行するエージェント型AIワークフローにも対応する。ユニファイドメモリ帯域幅は最大170GB/sで、M5より10%、M1より2.5倍向上している。
M5 Ultra:プロ向けワークロードとAI処理を強化
M5 Ultraは、複雑な3Dレンダリング、ビジュアルエフェクト、科学的解析、高負荷なAIモデルのオンデバイス実行など、高いCPU/GPU性能とメモリ帯域幅を必要とするプロ向けワークロードを想定したチップだ。
M5 Ultraは、デュアルダイ構成のM5 Maxを2基、次世代UltraFusionで接続し、Appleシリコン初のクアッドダイ構成としている。UltraFusionはダイ間の帯域幅を4.4TB/s以上に高め、接続密度も従来比で6倍以上に向上。この低レイテンシーかつ高速な相互接続により、4つのダイを1つの統合されたプロセッサとして動作させる。
M5 Ultraは、12のスーパーコアと24の高性能コアで構成される最大36コアCPUを搭載。M3 Ultraと比較して、シングルスレッド性能は最大1.25倍、マルチスレッド性能は最大1.3倍高速化している。
AI、グラフィックス、メモリ性能を強化
M5 Ultraは最大80コアの次世代GPUを搭載し、各コアにNeural Acceleratorを組み込んでいる。AI処理におけるGPUのピーク演算性能は、M3 Ultraと比較して最大4.5倍、M1 Ultraと比較して6倍以上向上したという。
GPUには、第2世代Dynamic Cachingを備えたシェーダコアのほか、ハードウェアアクセラレーテッドメッシュシェーディング、第3世代のレイトレーシングを搭載。グラフィックス性能はM3 Ultraと比較して最大40%高速化している。

M5 Ultraは、より高性能なメディアエンジンも搭載する。H.264、HEVC、4基のProResエンコード/デコードエンジン、ハードウェアアクセラレーテッドAV1デコードに対応し、高解像度映像の編集処理を高速化する。また、32コアNeural Engineを搭載し、AI処理やApple Intelligenceの機能をオンデバイスで実行できる。
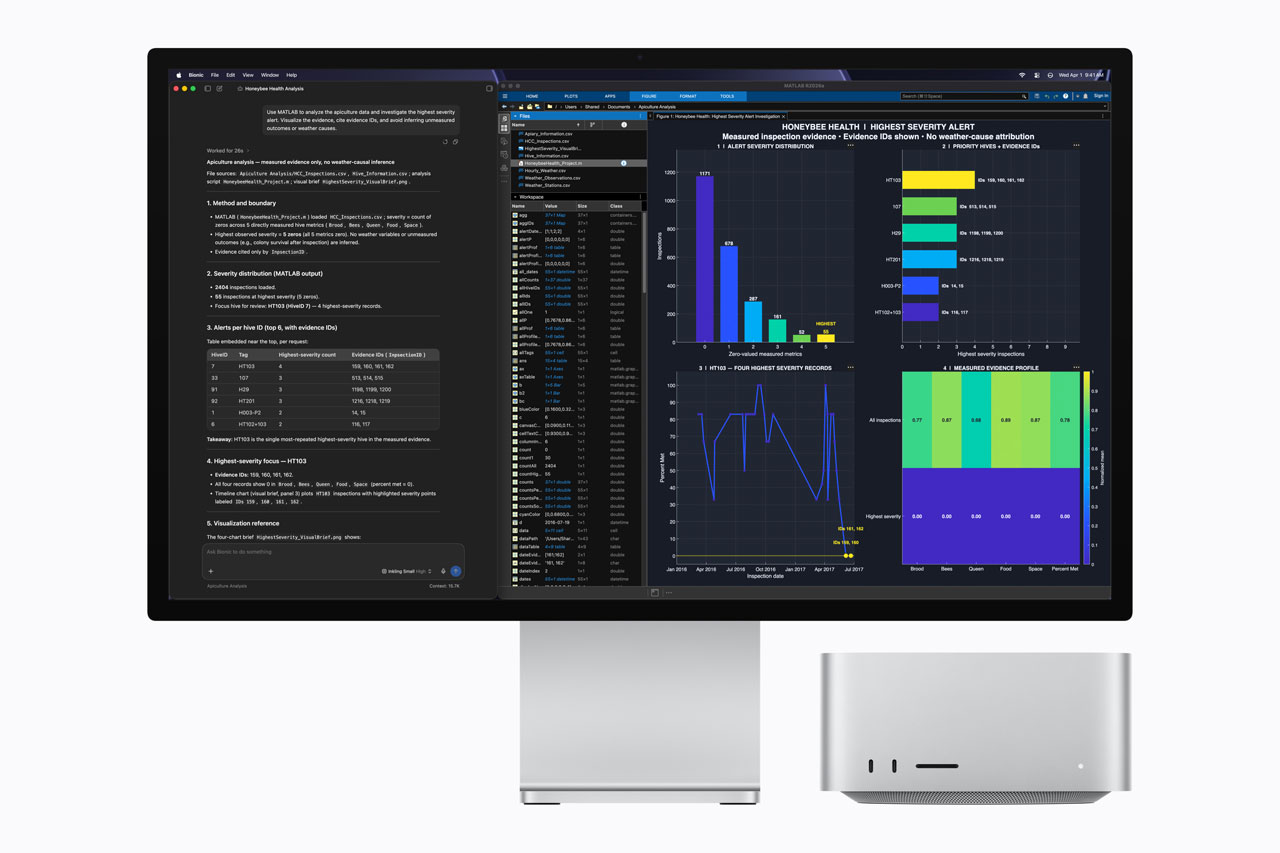
さらに、M5 Ultraは最大512GBのユニファイドメモリと、M3 Ultraと比較して50%高速な最大1.2TB/sのユニファイドメモリ帯域幅を備える。大規模なデータセットをローカルメモリ上で扱えるほか、トークン処理速度の向上や、数千億パラメータ規模のLLMのオンデバイス実行にも対応する。
デベロッパ向けフレームワークとツール
Core AI、Core ML、Metal、Xcodeなど、Appleのデベロッパ向けフレームワークとツールは、M6とM5 Ultraのハードウェア機能を活用できる。M6の16コアNeural Engine×2や、M5 Ultraの最大512GBユニファイドメモリ、最大1.2TB/sのメモリ帯域幅、GPUに組み込まれたNeural AcceleratorなどをAI処理に利用できる。
これらのフレームワークと新しいチップにより、Mac上で大規模なAIモデルの実行やファインチューニングが可能になる。Appleのデベロッパツールとフレームワークは、CPU、GPU、Neural Engine全体で処理を最適化し、Apple Foundation ModelsやApp Intentsを利用したApple Intelligence機能の組み込みや、独自のAIモデルを使ったオンデバイスAIワークロードの構築、実行に対応する。